In sintesi
ChatGPT funziona con un modello linguistico di grandi dimensioni (LLM): un sistema addestrato su enormi quantità di testo a prevedere la parola successiva, un pezzo alla volta. Da questa capacità nascono scrittura, sintesi e ragionamento. Il modello non consulta un archivio di fatti: per questo può sbagliare con sicurezza, e per questo conviene dargli documenti e fonti su cui lavorare.
- LLM: modello linguistico di grandi dimensioni.
- Token: i pezzi di testo che il modello legge e scrive.
- Contesto: quanto testo il modello considera in una volta.
- RAG: risposte basate su documenti forniti.
Come funziona ChatGPT, in una frase
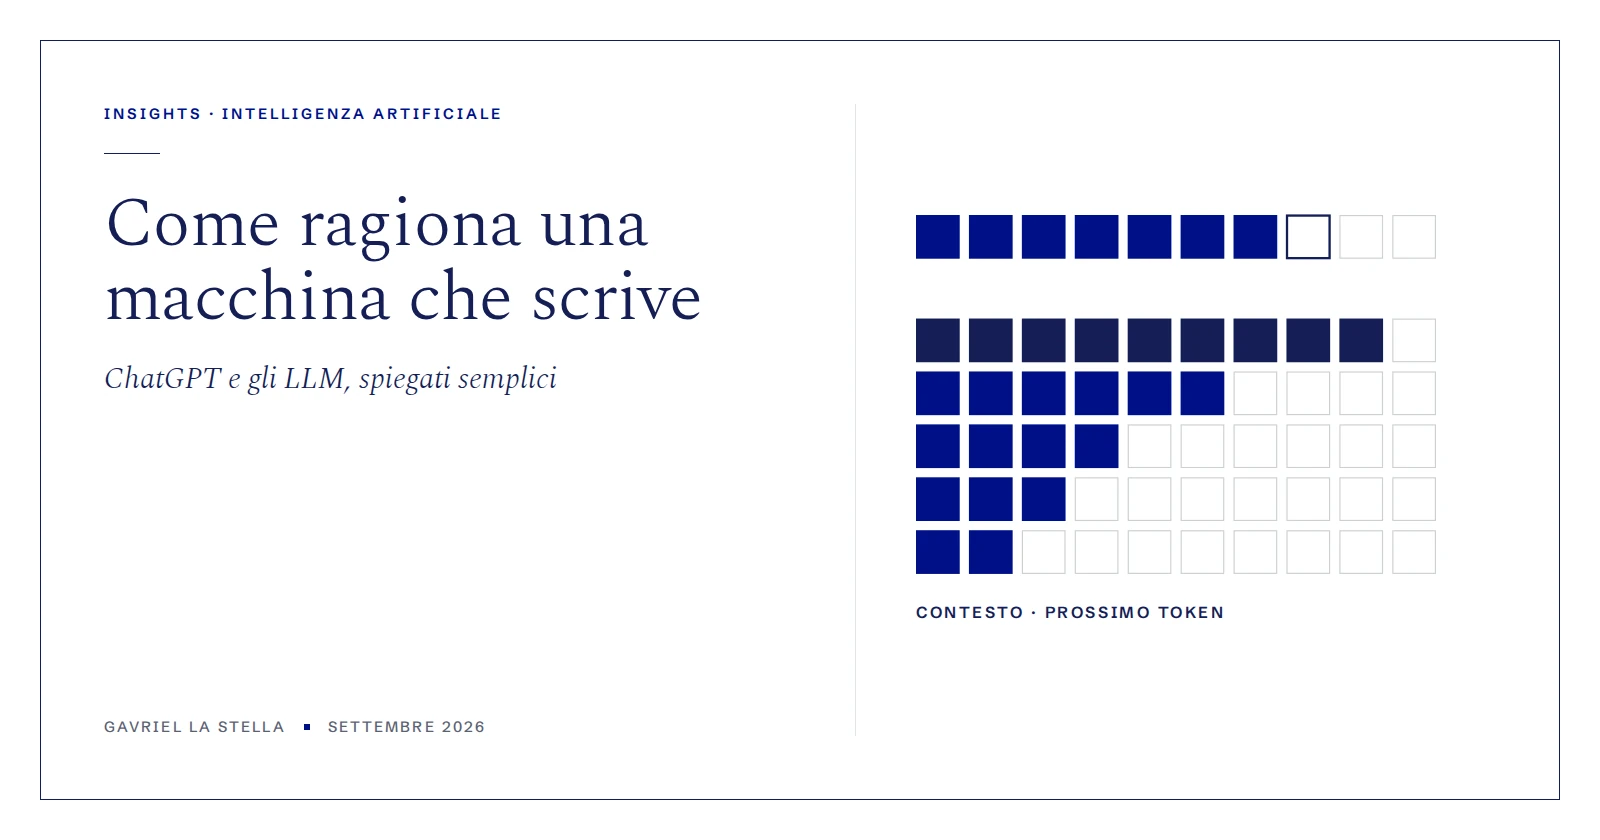
Un modello linguistico legge il testo ricevuto e calcola, tra tutte le parole possibili, quale è più probabile che venga dopo; la scrive, la aggiunge al testo e ripete. Una risposta di trecento parole è il risultato di centinaia di queste scelte in sequenza.
La tecnologia alla base è il Transformer, descritto da ricercatori di Google nel 2017 nell’articolo “Attention Is All You Need”. ChatGPT, lanciato da OpenAI il 30 novembre 2022, ha reso questa tecnologia accessibile a tutti.
Token: le unità con cui ragiona
Il modello non legge parole ma token: pezzi di testo che possono essere parole intere, parti di parola o segni. In italiano una parola vale in media più di un token. I token contano per due ragioni pratiche:
- Costo: le API si pagano per milione di token in ingresso e in uscita.
- Contesto: ogni modello ha un limite di token che può considerare insieme, chiamato finestra di contesto. I modelli del 2026 arrivano a centinaia di migliaia di token, l’equivalente di più libri.
Come si addestra un modello
- Pre-addestramento: il modello legge una quantità enorme di testi e impara a prevedere il token successivo. Qui acquisisce lingua, conoscenze generali e capacità di ragionamento.
- Affinamento: si allena su esempi di domande e risposte scritte da persone, per diventare un assistente utile.
- Apprendimento con feedback umano: persone valutano risposte alternative e il modello impara a preferire quelle giudicate migliori, più utili e più sicure.
Le conoscenze del modello si fermano alla data dei dati di addestramento. Per le informazioni recenti gli assistenti usano la ricerca web, come ChatGPT, Claude e Gemini, o i documenti forniti dall’utente.
Perché sbaglia: le allucinazioni
Il modello genera testo plausibile, non consulta una banca dati. Quando non ha l’informazione, può produrre una risposta convincente ma falsa: un numero, una sentenza, una citazione inesistente. Si chiama allucinazione.
- Si riduce fornendo i documenti su cui lavorare e chiedendo di citare le parti usate.
- Si riduce chiedendo di dire “non lo so” quando manca l’informazione.
- Non si elimina: cifre, nomi e riferimenti normativi vanno sempre verificati.
RAG, modelli che ragionano e strumenti
RAG (Retrieval-Augmented Generation) è la tecnica con cui il modello, prima di rispondere, recupera i passaggi pertinenti da un archivio di documenti e li usa come base. È così che funzionano gli assistenti aziendali sulla documentazione interna e le risposte con fonti delle ricerche AI, di cui parla la guida su AI Mode di Google.
I modelli che ragionano, diffusi dal 2024, dedicano più calcolo a una fase di pensiero prima di rispondere: rendono di più su matematica, codice e problemi in più passaggi, a costo di più tempo.
Con gli strumenti il modello può cercare sul web, eseguire codice, leggere file e agire su altre applicazioni: è la base degli agenti AI.
Glossario essenziale
| Termine | Significato |
|---|---|
| LLM | Modello linguistico di grandi dimensioni |
| Token | Pezzo di testo elaborato dal modello |
| Finestra di contesto | Quantità di testo che il modello considera insieme |
| Prompt | Le istruzioni e i materiali dati al modello |
| Temperatura | Quanto le risposte sono variabili o prevedibili |
| Allucinazione | Risposta plausibile ma falsa |
| RAG | Risposta basata su documenti recuperati |
| Multimodale | Capace di leggere e produrre testo, immagini, audio |
| Agente | Modello che usa strumenti per completare un compito |
Cosa cambia per chi lo usa
- Il contesto conta più della domanda: ruolo, obiettivo, esempi e documenti migliorano la risposta più di ogni formula.
- Chiedere la struttura: tabella, elenco, lunghezza, tono. Il modello segue il formato richiesto.
- Lavorare per passaggi: prima la scaletta, poi la stesura, poi la revisione.
- Verificare sempre: il modello è un collaboratore veloce, non una fonte.
Sono i principi del prompt engineering. Per scegliere l’assistente c’è il confronto tra ChatGPT, Claude, Gemini e Grok.
Domande frequenti
Come funziona ChatGPT in parole semplici?
È un modello linguistico addestrato su enormi quantità di testo a prevedere la parola successiva. Ripetendo questa previsione centinaia di volte scrive risposte, sintesi e ragionamenti.
Cos’è un LLM?
Un Large Language Model, o modello linguistico di grandi dimensioni: una rete neurale addestrata su grandi quantità di testo per comprendere e generare linguaggio. ChatGPT, Claude, Gemini e Grok sono basati su LLM.
Cosa sono i token?
Sono i pezzi di testo con cui il modello lavora: parole intere, parti di parola o segni. Determinano il costo delle API e quanto testo il modello può considerare insieme.
Perché ChatGPT a volte inventa?
Perché genera testo plausibile invece di consultare una banca dati. Quando manca l’informazione può produrre risposte false ma convincenti, dette allucinazioni. Fornire documenti e verificare i fatti riduce il problema.
Cos’è la RAG?
Retrieval-Augmented Generation: il modello recupera i passaggi pertinenti da un archivio di documenti e li usa come base per rispondere, citando le fonti.
ChatGPT impara dalle mie conversazioni?
Il modello non cambia durante la conversazione. Le conversazioni possono essere usate per addestrare modelli futuri solo se le impostazioni lo consentono; nei piani aziendali questo è escluso per impostazione.